
In questo articolo parleremo di alcuni elementi e concetti chiave dell’Intelligenza Artificiale (IA). Proveremo ad abbozzarne una sintetica storia al fine di mettere in evidenza come la sua trama è intessuta da aspetti tecnici, sociali e culturali che giustificano le pretese – da parte delle comunità umane in cui tali tecnologie si costruiscono e applicano – di criticare e controllare in generale i suoi sviluppi.
Tale pretesa, d’altronde, è utile per controbilanciare sia le narrative tese a esasperare le aspettative che intorno alla IA si generano, sia le accuse secondo cui queste critiche hanno il solo scopo di ostacolare/burocratizzare il libero sviluppo tecnologico – tesi spesso avanzate in maniera semplicistica e altamente interessata.
In generale, come sempre è avvenuto dal momento in cui abbiamo imparato a vivere in un sistema politico ed economico in cui si è ritenuto lecito lasciare alle cosiddette “libere” forze del mercato decidere sull’elaborazione e introduzione delle tecnologie negli ambiti sociali, siamo ora qui di nuovo impegnati a comprendere alcuni snodi problematici che questa impostazione cultural-filosofica comporta.
Relazione tra algoritmi, programmazione e macchine/computer
Algoritmi
L’IA è una tecnologia costituita da algoritmi, ovvero insiemi di procedure (ricette) automatizzabili che contengono elementi e ragionamenti capaci di sviluppare prodotti/funzioni. Partiamo dunque dagli algoritmi.
In termini generali, per essere effettivamente implementati gli algoritmi vanno tradotti/dettagliati – in tutti i loro passaggi – in programmi contenenti istruzioni primitive che possono essere comprese ed eseguite da persone o macchine, gli agenti che infine li realizzano rendendoli realmente funzionanti (Kneusel 2023).

L’interrelazione tra algoritmi, programmi e persone/macchine è necessaria nel momento in cui vogliamo realizzare – e pure, in qualche modo, “replicare”, in un ciclo più o meno continuo – il prodotto o la funzione in essa descritta.
Questo schema in fondo è al cuore delle tecniche di meccanizzazione – tipiche delle varie rivoluzioni industriali – ovvero della implementazione di processi automatici tramite macchinari che liberano dalla schiavitù lavorativa l’essere umano sebbene, come ricorda il sociologo e storico della tecnica Lewis Mumford, nella nostra civiltà industriale e capitalista ciò ha comportato sempre un rischio in quanto “la tendenza dell’automazione è di subordinare i fini umani ai mezzi originariamente creati per servirli” (1954).
Nel caso dell’IA questo avvertimento è ancora più prezioso in quanto si vogliono realizzare tecnologie automatizzate – macchine che percepiscono, ragionano, decidono, ecc. – capaci anche di incarnare quelle abilità umane considerate, nella gerarchia della vita terrestre, tra le più alte e distintive per la vita associata delle persone.
La stessa relazione tra algoritmi, programmi e lavoratori/macchine mette anche in evidenza come la realizzazione di tali procedure funzionali abbia un’anima antica in cui il soggetto realizzatore macchinico finale, il computer, è solo un’ultima innovazione.
Da questo punto di vista lo studioso culturale Ted Striphas è molto istruttivo quando dedica al concetto di algoritmo e al suo inventore – il matematico persiano del IX secolo d.C , Muhammad ibn Musa al-Khwarizm, padre dell’algebra, tanto citato ma mai indagato in tal senso – un lungo approfondimento per comprendere le origini sociali della cultura algoritmica, ovvero dell’antico bisogno umano di affrontare questioni complesse, anche morali, attraverso la matematica/computazione (2023).
Un importante indizio dei cambiamenti avvenuti nel tempo è che la stessa computazione si esprimeva anticamente attraverso il normale linguaggio quotidiano – solo successivamente è stata ingabbiata e formalizzata in simboli specifici manipolabili, e spesso comprensibili, dai soli specialisti.
Dunque un essere umano concepisce un algoritmo e traduce quell’algoritmo in una sequenza di passaggi (un programma contenente istruzioni) che viene data in input a un’impresa (lavoratori) o a una macchina – dagli anni 50’ del XX secolo, a una macchina speciale come il computer – capace di eseguire le istruzioni che lo implementano. Da notare che la macchina/il computer non capisce cosa sta facendo; sta semplicemente eseguendo, nel proprio specifico dominio (fatto di logica e matematica) una serie di istruzioni primitive.
Lo scopo dichiarato di volere automatizzare le capacità intellettive più sofisticate mette l’IA su un piano problematico di attenzione visto che i suoi dispositivi andranno a sostituire o integrare delle attività umane creando una nuova ecologia esistenziale, nuove reti relazionali e, soprattutto, nuovi assetti di potere.
Si pensi, per prendere uno dei temi più popolari, alla possibile riduzione dei posti di lavoro in settori che prima si pensavano indenni, come quelli intellettuali. Con l’industrializzazione l’automazione ha già ridotto di molto il lavoro umano nei settori estrattivi e manifatturieri nella maggior parte dei paesi del mondo. In essi è stato il settore dei servizi a rivelarsi fin qui una grande riserva e un propulsore di impiego grazie all’assorbimento di lavoro intellettuale, così intrecciato con l’ideazione e lo sviluppo delle tecnologie trasmissive e informative (Information & Communication Technology) che hanno espanso la progettazione, circolazione e vendita delle merci grazie a queste nuove tecniche di elaborazione simbolica e di controllo a distanza (Beniger 1994).
Ed è proprio il settore dei servizi quello in cui si prevede un massiccio impiego dell’IA. Anche solo rimanendo nei paradigmi economici liberali questo fatto richiede un nuovo approccio nei modi di ridistribuire la ricchezza di una produzione che sa o vuole fare a meno della qualità del lavoro umano – un approccio che non potrà ripudiare, ideologicamente, modelli innovativi e solidaristici sul piano sociale di fronte al crescente pericolo dell’impossibilità di convivere pacificamente l’un con l’altro.
Da questo punto di vista, nonostante ci si senta in obbligo di parlare di IA in ogni contesto, non vi è una grande eco di un dibattito politico che avanzi sul tema proposte specifiche.
Nascita dell’IA
Per funzionare l’IA ha bisogno di un computer. A volere essere precisi, lo stesso computer nasce come realizzazione di un algoritmo che si dimostrerà capace di elaborare qualunque altro algoritmo/calcolo un essere umano possa concepire (Wikipedia).
Ideato dal geniale matematico inglese Alan Turing (1912-1954), esso è stato definito come la macchina di Turing. La macchina astratta ideata da Turing è innovativa in quanto si distacca dallo scopo di eseguire un’attività fisica particolare – scavare, raccogliere, spostare, ecc.
In verità, anche essa è “una macchina che svolge un’attività fisica particolare, cioè selezionare o deselezionare determinate posizioni su un nastro in un determinato ordine. Ma la si può vedere sotto un’altra prospettiva, come un sistema che agisce su informazioni: un segno sul nastro è in questo senso un’informazione”. I filosofi la battezzarono come un neo-meccanismo.
Per Turing possono esistere una infinità di questo tipo di macchine in quanto esse “si distinguono per la loro tabella di istruzioni, che indica loro, a ogni fase, quale delle operazioni semplici di cui possono disporre devono applicare… Combinato alla tesi di Turing-Church, questo risultato ha per conseguenza che ogni calcolo che un uomo sia in grado di effettuare può essere realizzato da una macchina di Turing” (Adler 2023).
Allo stesso tempo, concettualmente il computer e l’IA nascono insieme se pensiamo al famoso articolo pubblicato nel 1950, e intitolato Computing Machinery and Intelligence, in cui lo stesso Turing si domandava se queste macchine potessero pensare spingendosi a ipotizzare che un giorno “saranno in grado di eguagliare gli uomini in tutti gli ambiti puramente intellettuali”.
Lo stesso scienziato mise a punto una prova per valutare, comparandone le capacità di dialogo interattivo, se il soggetto parlante fosse un essere umano o un computer – il cosiddetto test di Turing.
Il termine “intelligenza artificiale” è stato invece coniato negli anni ’50 del XX secolo dal famoso informatico John McCarthy (1927-2011). Il nucleo della sua definizione – l’IA è una tecnica che tenta di convincere una macchina, dal XX secolo in genere un computer, a comportarsi in modi che gli esseri umani ritengono intelligenti – rivela plasticamente come essa sia una scienza sperimentale, ovvero una ricerca fondata su tentativi di sviluppi, assemblaggi e simulazione che prende spunto, innanzitutto, da saperi informatici e ingegneristici.
Dipendendo in maniera esiziale dal successo dei propri esperimenti – qualunque finanziatore, pubblico o privato, deve giustificare i propri esborsi, o rispetto alle priorità di intervento per la spesa pubblica, o in termini di ritorno degli investimenti – vedremo come la storia dell’IA sia caratterizzata da periodi di grandi finanziamenti (estati) seguiti, in seguito a un qualche fallimento nelle aspettative promesse, da anni contrassegnati dalla scarsità di fondi (inverni).
Mantenere l’hype costantemente in alto e parlare in maniera iperbolica di ogni suo aspetto – anche nei supposti risvolti distopici, così che possano eventualmente essere controllati nelle loro derive – è parte di una strategia complessiva che serve a non fare cadere la tensione e farsi in ogni caso ricordare – da parte dei vari decision maker – come tema importante su cui è doveroso investire.
Human in the loop: i diversi tipi di algoritmi e il ruolo del programmatore umano
Le diverse possibilità di rendere intelligente una macchina
Fin dalla sua nascita l’IA ha pensato diversi modi per modellare l’intelligenza – ovvero gli algoritmi ed è questo il motivo per cui, generalmente, vediamo rappresentazioni in cui il campo dell’IA è rappresentato in almeno due sottocampi – l’IA simbolica e l’IA subsimbolica o connessionista (machine learning e deep learning fanno parte di quest’ultima).
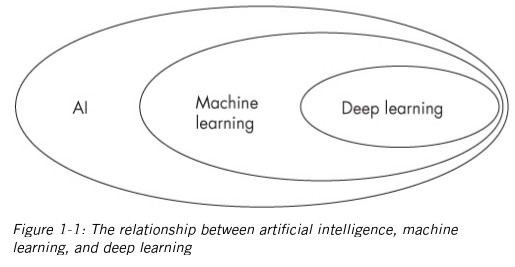
IA simbolica e IA subsimbolica (connessionismo)
Con l’IA simbolica si tenta di modellare l’intelligenza (l’algoritmo) programmando le macchine attraverso simboli e dichiarazioni o associazioni logiche. Utilizziamo i simboli come elementi di pensiero e linguaggio per sviluppare e trasferire i ragionamenti ed è praticamente ciò che fa ogni programmatore software quando programma i computer con i diversi linguaggi di programmazione inventati di generazione in generazione (Assembler, Pascal, Fortran, C, Lisp, ecc.).
L’IA simbolica parte dal presupposto che l’intelligenza può essere raggiunta in astratto e non si preoccupa di dover simulare un substrato che assomigli a un cervello umano per averla. In termini di programmazione informatica questo è un approccio top-down: si inizia con un analisi delle attività di alto livello e quindi si suddivide tale attività in parti sempre più piccole.
Il filone della IA simbolica ha avuto nei sistemi esperti – sistemi che incorporano un vasto knowledge base organizzato e usato per gestire una determinata area di azione – un indubbio successo calmierato dal fatto che tanta parte della conoscenza umana è però tacita/incorporata, e quindi impossibile da spiegare/codificare simbolicamente.
Con l’IA del connessionismo/subsimbolica si tenta di modellare l’intelligenza (l’algoritmo) costruendo reti di componenti più semplici. I connessionisti seguono lo sviluppo evolutivo del cervello: l’intelligenza (comunque definita) emerge dalla cattura di piccoli elementi significativi, alla stregua di ciò che i neuroni umani, intesi come semplici processori ma organizzati in reti complesse, riescono a fare con le nostre menti.
In termini di programmazione informatica abbiamo un approccio bottom-up: si inizia con parti più piccole e le si combinano insieme. Possiamo notare che la mente umana incarna tutte e due gli approcci (deduttivismo e induttivismo).
La costruzione degli algoritmi nell’IA
IA simbolica
Nell’IA simbolica un programmatore, come per tutti gli algoritmi tradizionali che popolano i computer dagli anni 50’, stabilisce le istruzioni in anticipo avendo conoscenza piena di come articolare l’algoritmo nella macchina. In termini di programmazione informatica implementiamo l’algoritmo che vogliamo istruendo il computer passo dopo passo.
IA subsimbolica (machine learning, deep learning)
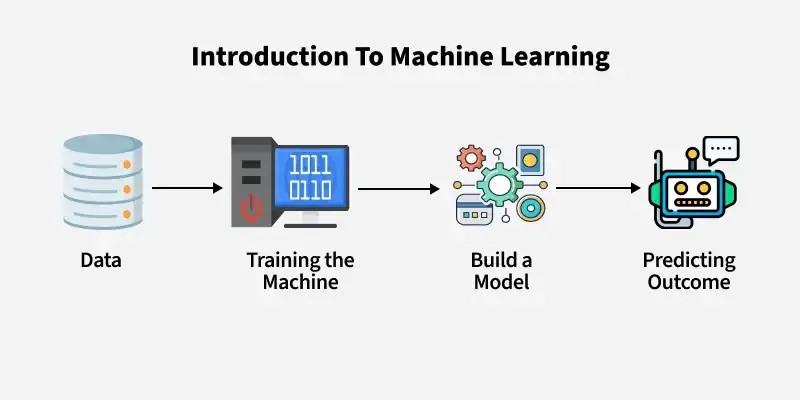
Nell’IA connessionista, invece, l’algoritmo stesso “impara” le istruzioni tramite “dati di allenamento”. Ad esempio, nessuno dice a questo tipo di algoritmo IA
come classificare le transazioni della carta di credito. L’algoritmo, invece, analizza molti esempi da ognuna delle due categorie (fraudolenta o non fraudolenta) e trova uno schema per distinguere l’una dall’altra. Qui il ruolo del programmatore non è dire all’algoritmo che cosa fare. È dire all’algoritmo come imparare che cosa è necessario fare, usando i dati a disposizione e le regole della probabilità (Polson, Scott 2019).
L’ascesa dell’IA subsimbolica e delle reti neurali
I principi dell’IA subsimbolica
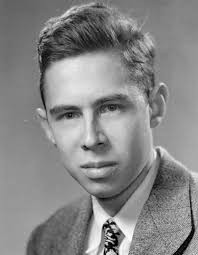
Nel 1957, Frank Rosenblatt (1928 –1971) della Cornell University creò il Mark I Perceptron, ampiamente riconosciuto come la prima applicazione delle reti neurali.
Rosenblatt è uno psicologo con interessi scientifici vasti e la sua idea è di sfruttare la capacità processiva dei neuroni del cervello umano replicandone le funzioni matematicamente con il cosiddetto percettrone.
Come sappiamo in biologia, il neurone è un corpo cellulare a cui arriva energia attraverso dei filamenti in entrata (dentriti). Nel momento in cui tale energia raggiunge una determinata soglia si dice che il neurone – in relazione alla funzione su cui si è plasmato – si “accende” rilanciando a sua volta una certa energia in uscita su un altro filamento (assone) che la distribuisce alle altre cellule connesse.
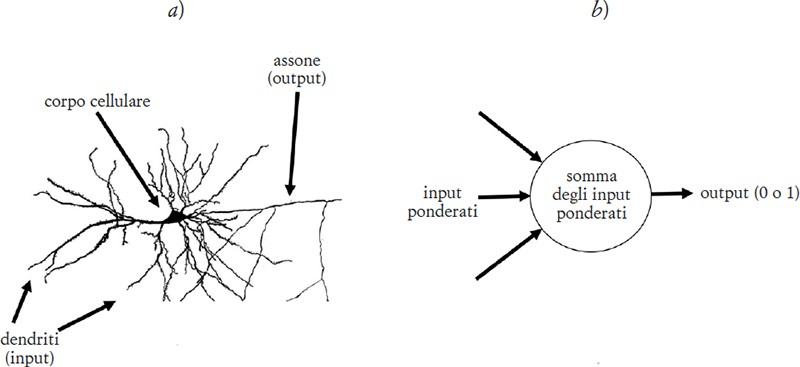
Figura 2. a) Un neurone del cervello; b) un percettrone semplice
Il percettrone di Rosenblatt è una funzione matematica che raccoglie gli input ponderati in entrata per produrre un output (zero o uno) in uscita. Gli input si dicono ponderati perché interpolano i valori in entrata con dei parametri che permettono al percettrone di “accendersi” solo nel momento in cui il compito assegnato è stato raggiunto rilasciando così in uscita il valore aspettato (zero o uno, o un numero tra 0 e 1 che ne rappresenta la probabilità). Come vedremo, l’aggiustamento di quei parametri è il fine dell’addestramento della macchina.
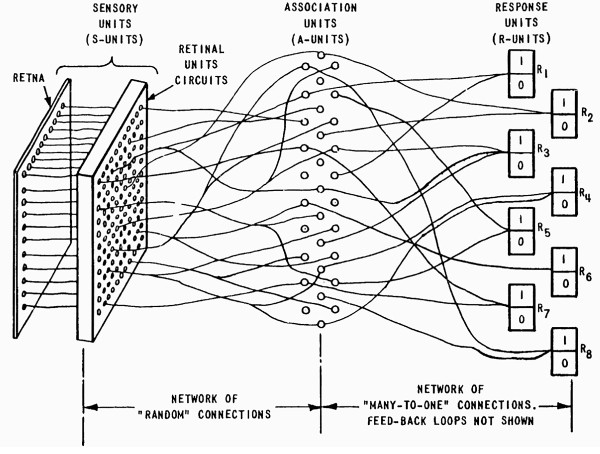
Il Perceptron utilizzava un’immagine televisiva digitalizzata da 20×20 pixel come input, che veniva poi passata attraverso un insieme “casuale” di connessioni a un set di unità di associazione che portavano ad un’unità di risposta.
In breve, un percettrone è un programma semplice che prende una decisione sí-o-no (1 o zero), basata sul fatto che la somma dei suoi input ponderati corrisponda a un valore soglia. Ispirato dalle reti di neuroni presenti nel cervello, Rosenblatt avanzò l’ipotesi che reti di percettroni potessero svolgere dei compiti, come riconoscere volti e oggetti.
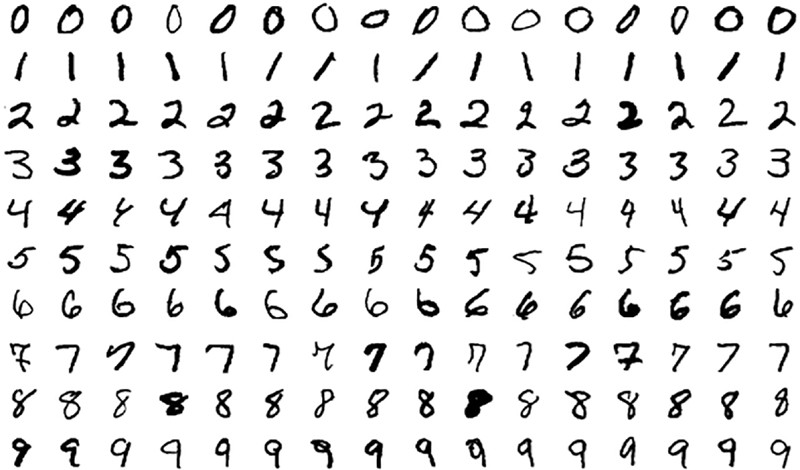
Rosenblatt ebbe successo nel far riconoscere delle immagini, nello specifico delle cifre scritte a mano. Spieghiamo più nel dettaglio l’esperimento (Mitchell 2022).
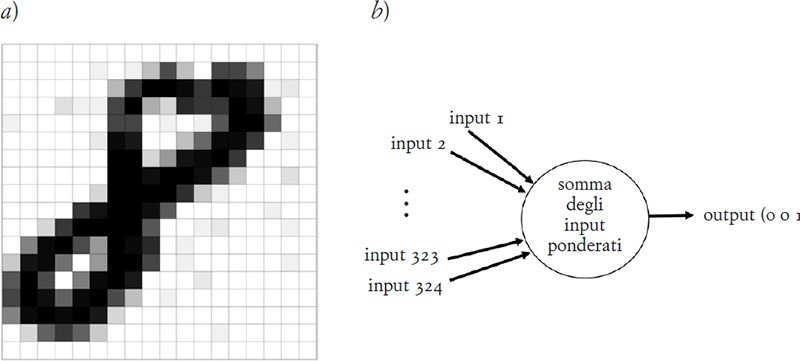
In questo caso il percettrone ha 324 input (ossia 18 × 18), ciascuno dei quali corrisponde a un pixel della griglia 18 × 18. Data una certa immagine ciascun input del percettrone è impostato secondo l’intensità del pixel corrispondente. Ciascun input ha il proprio valore ponderale (non mostrato nella figura).
Il funzionamento del “neurone”
Si vuole che il “neurone” elabori determinate caratteristiche di un “oggetto” per darci un output che porta a un’etichetta di classe – x, w, b sono numeri, h è una funzione algoritmica di attivazione propria del cosiddetto “neurone” che produce il numero di output.
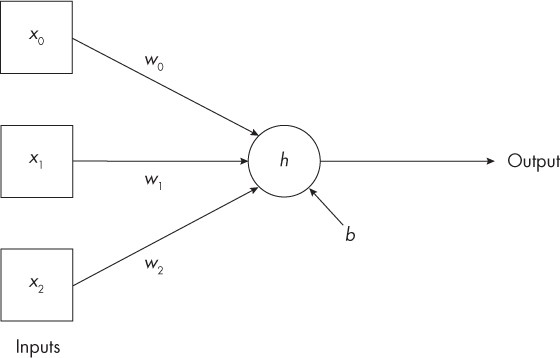
( x0, x1, x2) vettore di caratteristiche dell’“oggetto”
Questa rete neurale minimale (un neurone) vede in input un oggetto descritto da un vettore (insieme di numeri) costituito da tre caratteristiche tipiche (x0, x1, x2). La funzione di attivazione (h) più usata è la REctified Linear Unit (ReLU) – ed è una domanda: l’input (la somma degli input moltiplicata per i singoli pesi w0, w1, w2, più la distorsione b associata al neurone) è minore di zero? In tal caso, l’output è zero; altrimenti, è qualunque numero sia l’input.
Il neurone funziona in questo modo:
1) Moltiplica ogni valore di input, x0, x1 e x2, per il suo peso associato, w0, w1 e w2;
2) Somma tutti i prodotti del passaggio 1) insieme al valore di bias, b. Ciò produce un singolo
numero;
3) Fornisce il singolo numero a h, la funzione di attivazione, per produrre l’output, anch’esso un
singolo numero.
Praticamente tutti i fantastici risultati dell’IA attuale – identificare le razze di cani, guidare un’auto o tradurre dal francese all’inglese – sono dovuti a insiemi di questo costrutto primitivo (il cosiddetto modello)!!
La complessità degli insiemi neurali
Ovviamente per funzionare in maniera adeguata su problemi complessi le reti neurali devono essere formate da più neuroni ma con il loro incremento crescono inevitabilmente i parametri (pesi e bias) necessari alla loro ottimizzazione, ovvero alla definizione delle soglie di “accensione” giuste per poter dire che soddisfano la funzione per cui sono progettati.
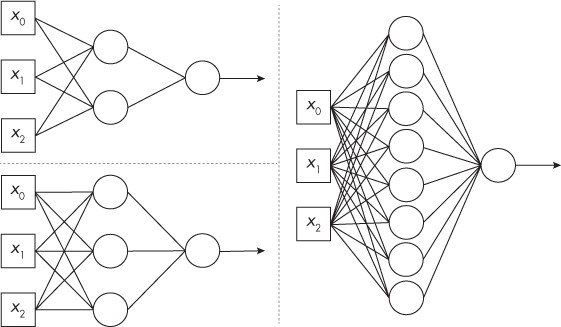
Consideriamo modelli neurali semplici (2, 3, 8 nodi). Quanti parametri numerici (pesi e bias) sono in gioco nei vari modelli?
Abbiamo bisogno di un peso per ogni linea (tranne per la freccia di output) e un valore di bias per ogni nodo. Quindi: 1) per 2-nodi: 8 pesi e 3 valori di bias; 2) per 3-nodi: 12 pesi e 4 bias; 3) per 8-nodi: 32 pesi e 9 valori di bias.
Le reti neurali del XXI secolo
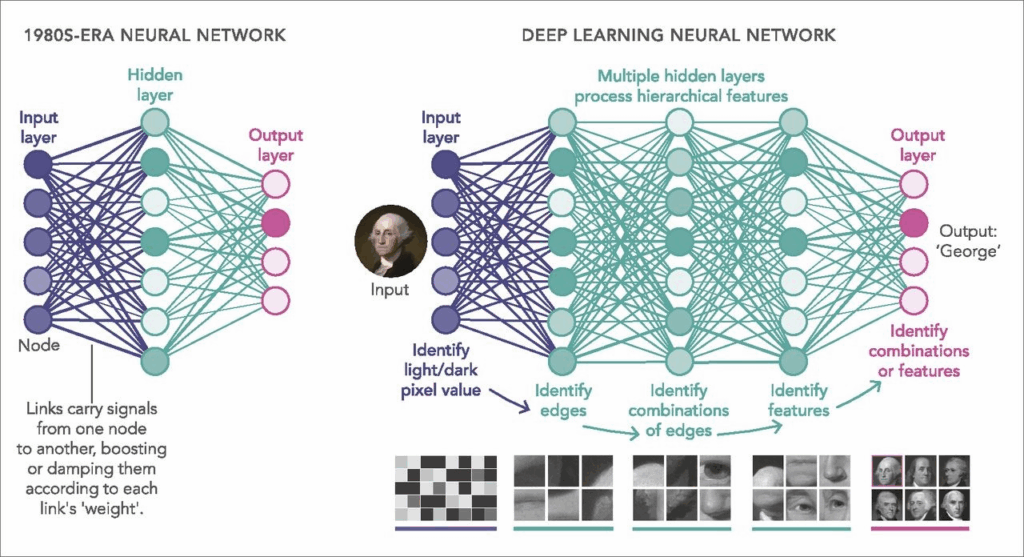
Le architetture delle reti neurali si sono nel tempo sviluppate grazie soprattutto alle accresciute performance dei computer in termini di memorie e potenze di calcolo tanto che, ad esempio, gli ormai famosi modelli Large Language Model (LLM) di IA abbondano di strati di nodi per cui – per dire – ChatGPT 3 e ChatGPT 4 funzionano con architetture neurali e numero di nodi che richiedono una quantità di parametri (pesi e bias) di, rispettivamente, 175 miliardi e 1,7 trillioni!!
Cosa si vede di un modello/algoritmo addestrato?
A questo punto vi sono delle domande che è lecito farsi riguardo alla possibilità di comprendere, rispetto al tipo di algoritmo definito (simbolico/connessionista), quali sono le logiche che governano la qualità delle risposte fornite dai modelli – le persone che si trovano ad avere risposte da sistemi IA per questioni legali e giudiziarie, per avere erogazioni di finanziamenti, per superare fasi assunzionali, per avere prestazioni sanitarie, ecc. dovrebbero avere spiegazioni in proposito, e non doversi accontentare della buona fede della IA.
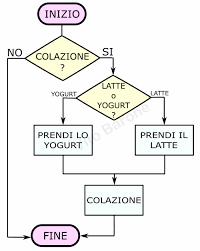
Se si vuole esaminare un algoritmo simbolico è possibile costringere l’impresa che lo ha creato a mostrare i codici sorgenti degli applicativi. Nel paradigma del software open source ciò non è necessario essendo i software “aperti” per definizione all’esame pubblico – siamo in un ottica di open science, e quindi di bene comune, e i codici sorgenti sono leggibili anche per rendere possibile un miglioramento da parte degli altri.
Comunque, anche se si trattasse di software proprietario, in caso di necessità un’autorità pubblica ha il potere di richiederlo e ottenerlo. L’eventuale esperto informatico non avrebbe in tal caso difficoltà a ricostruire il flusso logico – in termine tecnico, il flow chart del ragionamento – che le istruzioni del programma hanno disegnato.
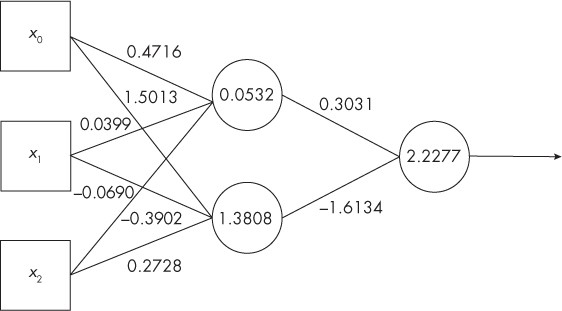
Prendiamo invece il caso di un algoritmo subsimbolico, ad esempio questo semplice modello neurale con uno strato nascosto di 2 nodi con cui il suo ideatore (Kneusel 2023) riesce a far distinguere, con una discreta probabilità di indovinare, due qualità di vitigni diversi fornendo in entrata 3 tipici parametri descrittivi per ognuno di essi.
Anche quando il creatore è costretto a rivelare la sua struttura – e qui siamo davanti a un modello ultra-semplice, con solo una decina, e non miliardi, di parametri! – può far vedere solo il valore di settaggio finale dei pesi e bias con cui il modello funziona – e per la vista di tali parametri in questo tipo di algoritmi si parla appropriatamente di open weight.
Se il modello risponde in maniera insensata – le cosiddette allucinazioni – non vi è modo di capire perché lo ha fatto. E spesso gli stessi operatori umani che hanno lavorato alla sua elaborazione in fase di impostazione architetturale e training non riescono nemmeno a spiegare le ragioni per cui i modelli riescono ad acquisire particolari abilità (Mitchell 2022).
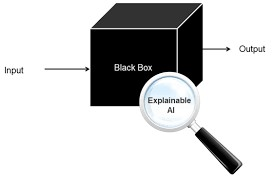
Come si intuisce, siamo in una situazione di black box in cui, almeno per la parte di algoritmi costruiti con le reti neurali, non si riesce a spiegare agli altri la sua logica di funzionamento – quando si parla di explainable AI si chiede di risolvere proprio questo tipo di limite.
Le condizioni per l’apprendimento automatico: big data e potenza di calcolo
L’algoritmo di addestramento nel machine learning
Un modello di apprendimento automatico è una scatola nera che accetta un input, solitamente una raccolta di numeri (i vettori che descrivono l’”oggetto” attraverso sue specifiche caratteristiche) e produce un output, solitamente un’etichetta come “bicicletta” o “automobile”, o un valore continuo come la probabilità di essere una “automobile”.
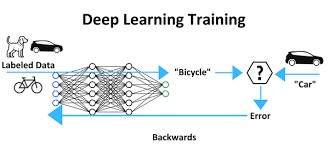
Il modello ha dei parametri che ne controllano l’output. Il condizionamento di un modello, noto come addestramento, cerca di impostare i parametri affinché si produca l’output corretto per un dato input.
L’addestramento implica che abbiamo una raccolta di input e di output che il modello dovrebbe produrre quando vengono forniti quegli input. Perché vogliamo che il modello ci dia un output che abbiamo già?
La risposta è che, in un momento futuro, avremo input per i quali non abbiamo già l’output. In effetti il punto centrale è creare un modello per usarlo con input sconosciuti e credere al modello quando ci fornisce un output.
L’addestramento usa la raccolta di input e output noti per adattare i parametri del modello al fine di ridurre al minimo gli errori. Se riusciamo a farlo, iniziamo a credere agli output del modello quando ci vengono forniti nuovi input sconosciuti.
Ecco, quindi, l’algoritmo di apprendimento automatico:
1) Raccogli un set di dati di training costituito da una raccolta di input per il modello e dagli output;
2) Seleziona il tipo di modello che vogliamo addestrare;
3) Addestra il modello presentando gli input di training e regolando i parametri del modello quando sbaglia gli output;
4) Ripeti il passaggio 3) finché non siamo soddisfatti delle prestazioni del modello;
5) Utilizza il modello ora addestrato per produrre output per nuovi input sconosciuti.
Il fugace successo del percettrone
Nel 1957 il Mark I Perceptron di Frank Rosenblatt, che collaborava con la USA Naval Research, fu accolto in maniera entusiasmante:
“La marina militare ha rivelato oggi l’embrione di un calcolatore elettronico che, a suo giudizio, sarà capace di camminare, parlare, vedere, scrivere, riprodursi ed essere cosciente della propria esistenza. E si prevede che, un domani, i percettroni sapranno riconoscere le persone, pronunciare ad alta voce il loro nome e tradurre all’istante la parola di una lingua nella parola e nella scrittura di un’altra lingua” (New York Times 1958).
Evidentemente, eravamo 60 anni in anticipo!
All’ottimismo e ai relativi finanziamenti segui il pessimismo. Addestrare le reti neurali e metodi simili per risolvere problemi del mondo reale si rivelava talvolta un processo lento da morire, e spesso poco efficace, per via della quantità limitata di dati (per giunta digitalizzati ed etichettati) e di potenza di calcolo disponibile al tempo.
Cosa rende possibile ora l’IA subsimbolica?
Passati 60 anni molte cose sono cambiate: basti solo pensare a come abbiamo infrastrutturato ora le nostre vite, così immerse nel computing e nella infosfera. Due grandi temi la fanno da padrone nello spiegare il cambio delle condizioni.
Velocità dei computer
Nel 1945, l’Electronic Numerical Integrator and Computer (ENIAC), il computer più potente al mondo aveva una capacità elaborativa, in termini di milioni di istruzioni per secondo (MIPS), di 0,00289, circa 3.000 istruzioni al secondo. Nel 1980, il personal computer raggiungeva 0,43 MIPS, circa 500.000 istruzioni al secondo. Nel 2023 un personal computer di capacità medie con CPU Intel i7-4790, 130.000 MIPS – 300.000 volte più veloce del pc anni 80’, 45 milioni di volte più veloce dell’ENIAC.
Tuttavia, è con l’affiancamento delle Graphic Processor Unit (GPU) alla comune Central Processor Unit (CPU) che si ha un’ulteriore e incredibile innalzamento delle performance se pensiamo che la GPU A100 di NVIDIA raggiunge 312 teraflop (TFLOPS), o 312.000.000 MIPS: 730 milioni di volte più veloce pc anni 80’ e 110 miliardi di volte più veloce dell’ENIAC.
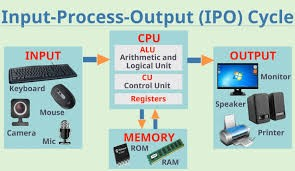
Per meglio precisare, l’architettura classica del computer prevede almeno un CPU, e questa lavora in maniera sequenziale eseguendo una istruzione dietro l’altra.
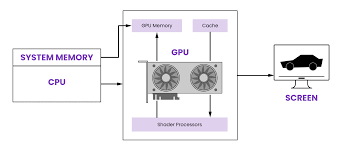
Le unità di elaborazione grafica (GPU) si sono aggiunte nel momento in cui si rendeva necessario sia migliorare le interfacce utente sia gestire la fruizione veloce di immagini – si pensi ai videogiochi – rendendo più semplice il trattamento del rendering video.
Le GPU sono state sviluppate per supportare una grafica veloce – esse possono eseguire simultaneamente la stessa operazione, come “moltiplicare per 2”, su centinaia o migliaia di posizioni di memoria (leggi: pixel). Se una CPU vuole moltiplicare mille posizioni di memoria per 2, deve moltiplicare la prima, la seconda, la terza e così via in sequenza.
Le GPU, come ormai sappiamo, sono l’ingrediente necessario a supportare anche i calcoli delle reti neurali in quanto si mettono a disposizione dei programmatori per velocizzare la quantità spropositata di operazioni che i miliardi di paramentri dei modelli richiedono, sia in fase di addestramento che nelle fasi di inferenza (quando forniscono le risposte ai nostri prompt, nel caso degli LLM).
Un argomento spinoso e collaterale a questo enorme sforzo computazionale è quello dei consumi energetici e del condizionamento ambientale degli apparati che richiedono risorse (produzione di elettricità e acque refrigeranti) che stanno mettendo in crisi la sostenibilità delle strutture comuni degli impianti civili (Pozza 2025).
Ad ogni modo, per avere una sensazione di quanto è lievitata la potenza di calcolo consideriamo il fatto che nel 1951 l’Alfa Romeo 6C viaggiava a 180 chilometri orari. Se le automobili avessero seguito la stessa crescita esponenziale dei computer, oggi viaggerebbe a otto milioni di volte la velocità della luce! (Polson, Scott 2019).
Big Data: alta disponibilità di dati digitalizzati
La Library of Congress, la biblioteca più grande al mondo, occupa 10 terabyte di memoria ma, nel solo 2013, le quattro più grandi aziende di tecnologia – Google, Apple, Facebook e Amazon – hanno raccolto dati per un ammontare 120 000 volte maggiore. Nel 2017, più di 300 ore di video sono state caricate su YouTube ogni minuto, e più di 100 milioni di immagini sono state caricate su Instagram ogni giorno.
Sappiamo che i modelli neurali imparano dai dati; più sono, meglio è, perché più dati significano una rappresentazione migliore di ciò che il modello incontrerà quando verrà utilizzato. Senza grandi set di dati, e dati che hanno già associate le proprie etichette, il deep learning non può imparare.
I big data e la realtà caotica della cultura algoritmica
La realtà caotica della cultura algoritmica è il titolo del talk che la studiosa dei media digitali, l’americana danah boyd, ha dedicato nel 2018 al contesto sociale in cui le persone operano da quando hanno come sistema operativo di vita l’infosfera di internet.
Oggi sappiamo che per poter partecipare a questa nuova corsa all’oro che sembra essere lo sviluppo di applicazioni di IA – diventata una industria miliardaria fatta diventare geopoliticamente strategica – bisogna possedere capacità di calcolo straordinaria e, soprattutto, possibilità di operare con i big data.
La capacità di calcolo, a dire il vero, si può anche acquistare dai provider di servizi cloud. Se si hanno i capitali è quindi possibile superare questo limite, a meno di non incappare in qualche blocco politico perché si è una azienda di una determinata regione del mondo. Gli Stati Uniti hanno politiche tecnologiche restrittive, ad esempio, verso la Cina per difendere il proprio vantaggio nell’IA. Essendo la nazione che ha il principale produttore di schede GPU (Nvidia) e i cloud provider più importanti consente commercialmente solo accordi limitati in questo specifico settore.
L’ossessione per i big data
Il problema dei big data invece è, in generale, molto più limitativo. Per operare nell’IA – a meno di non voler sviluppare applicazioni di nicchia – qualunque piccola o media impresa deve poter contare sulle grandi quantità di dati necessari ad allenare le reti neurali e queste possono essere generate solo su scala “internet”, una scala di azione e di opportunità che sappiamo è ormai da tempo riserva di poche big tech riassunte dall’acronimo GAFAM (Google, Amazon, Facebook, Apple, Microsoft) o da realtà asiatiche come Alibaba, Tencent, Baidu, ecc.
Il talk della boyd è dedicato proprio alla ossessione che si è generata, da parte delle aziende high-tech, verso i big data.
In generale l’ossessione per i dati da parte delle imprese dell’online ha molte ragioni. Una è la volontà di interfacciare con proprietà ed efficacia le persone che si rivolgono ai loro servizi per conquistarli indefinitamente – velocità e qualità di interazione sono un must per questi ambienti e i dati accumulabili sugli eventi a contorno una cornice operativa utile a coordinarli. Un’ altra, che rimane in linea con la prima, è di avere le munizioni per alimentare e costruire algoritmi predittivi sempre più sofisticati, per rimanere leader del settore e ideare e costruire nuovi tool e prodotti. Insomma, senza big data – volumi di dati enormi e rinnovabili, variamente combinati per coprire tutte le casistiche – non è possibile costruire modelli efficienti e innovare con le diverse declinazioni degli algoritmi dell’IA.
Ma questo modo di costruire applicazioni attraverso l’addestramento sui dati estratti e accumulabili online ha anche un’implicazione di fondo preoccupante, a livello culturale e sociale, almeno per due ragioni. La prima è che si progettano funzioni inerziali perché plasmate su schemi passati, fissando e perpetuando condizioni che rispecchiano determinati assetti valoriali e di potere, imponendoli tra l’altro indiscriminatamente a tutti vista la natura virale e globale dei servizi digitali. La seconda è che si riserva una grande fiducia nella qualità e rappresentatività dei dati così generati.
L’origine sociale dei dati
Tuttavia, quando si parla di big data si parla delle persone che svolgono ormai una parte importante delle loro attività nell’infosfera. I dati digitali hanno dunque una dimensione sociale e se l’IA connessionista si addestra su tali dati abbiamo una bella quantità di problemi da affrontare.
La studiosa è molto critica su questa idea di considerare i dati come il Sacro Graal per la risoluzione tramite l’IA di problemi che sappiamo spesso anche essere intrattabili per il semplice fatto che su di essi abbiamo opinioni contrastanti. Ad esempio, se nel campo della medicina tutti concordano di avere migliore cure, sul concetto della giustizia penale ci sono opinioni molto diverse, a volte incompatibili – dobbiamo soprattutto punire o recuperare le persone che sbagliano? Diviene chiaro quindi perché gli esempi per spingere gli sviluppi IA richiamino spesso i benefici apportati in ambiti su cui vi è unanimità di vedute nonostante poi le sue applicazioni e metodologie siano applicate trasversalmente a tutti i contesti sociali.
Ma la critica di fondo più potente riguarda la qualità dei dati digitali e la loro essenza aperta alla manipolazione/interpretazione – i dati vanno sempre trattati, o come dice la boyd, ” ben cotti” per essere utilizzabili.
Vi sono problemi ad ogni livello, già a partire dalla loro raccolta, un vero e proprio far west che l’IA, con la sua fame di dati, ha esasperato letteralmente “rubando” tutto ciò che trova sulla sua strada in internet senza chiedere il permesso ai legittimi proprietari – il trend è il solito, e pure peggiorato “non chiedere il permesso preventivamente e casomai scusarsi se scoperti”.
Per un giusto rapporto tra aziende e persone la scelta informata dovrebbe essere la regola, le tecniche estorsive un male da evitare, e lo stesso dovrebbe valere per l’acquisizione, e poi l’uso, di dati ottenuti per circostanze indirette – per la boyd è quest’ultimo il tipo di raccolta più in voga, agevolato dalla scarsa preoccupazione che le stesse persone riservano al tema, nonostante i dati personali siano né più né meno il loro “dna”.
La qualità dei dati
I software neurali si addestrano dunque su basi statistiche ma sappiamo delle difficoltà che ci sono nell’avere campioni di dati realmente rappresentativi di una certa distribuzione – e i problemi rimangono anche quando vi è la speranza che una raccolta massiccia (e su scala internet) lo risolva per il fatto di inglobare una enormità di esempi.
I dati digitali in effetti sono prodotti nelle (caotiche) dinamiche di interazione degli ambienti digitali dove tra l’altro è comune trovare assenze su temi non popolari – il cosiddetto “vuoto dei dati” – un fatto che crea ad altri opportunità per inserire sull’argomento “mancante” distorsioni o hackeraggi (Google bombing) al fine di minarvi il senso o portare adepti alle proprie tesi.
Inoltre, i dati possono essere sovra- o sotto-rappresentati per certe categorie generando o amplificando pregiudizi. Per non parlare poi delle persone che giocano appositamente con i sistemi algoritmici per sfruttarne le falle immettendo in rete dati che risultano privi di senso al di fuori di questo contesto “truffaldino”.
I pericoli dei nuovi autoritarismi
Il talk è del 2018 ma non sembra aver perso smalto critico se pensiamo allo scenario che viviamo riguardo allo stato dell’informazione online con lo sviluppo degli ultimi algoritmi della IA generativa, capaci di creare – su input suggeriti dagli utenti – testi e video realistici su fatti fantasiosi clonando tra l’altro voci e corpi di persone reali. I richiami ai temi etici della boyd tramite la figura di Hannah Arendt sembrano allora ancora più illuminanti di fronte ai nuovi pericoli autoritari/tecnocratici – come scriveva la storica e filosofa nonché critica dei poteri forti, “il suddito ideale del regime totalitario non è il nazista convinto o il comunista convinto, ma l’individuo per il quale la distinzione fra realtà e finzione, fra vero e falso non esiste più” (1954).
Ammortizzatori e spugne morali
In ultimo, la boyd ci rammenta il costante pericolo che, come creatori di sistemi socio- tecnici, affrontiamo, ovvero quello di rilasciare sistemi automatizzati in cui gli esseri umani hanno solo un ruolo figurativo funzionando come una moral crample zone – la definizione si deve alla studiosa ed esperta della relazione tra dati e società Madaleine Elish (2019).
La crample zone è quella parte di autoveicolo costruito per ammortizzare gli urti. Per Elish siamo in presenza di una moral crample zone ogni volta che un essere umano è tenuto nel contesto di funzionamento di un meccanismo (human in the loop) come soggetto rassicurante nonostante si sappia che un suo eventuale intervento in caso di guasto sia altamente problematico vista la sofisticazione e automazione del sistema e il continuo demansionamento funzionale che in esso l’operatore umano sperimenta.
Nel momento in cui si produrranno dei guasti critici l’attore umano avrà probabilmente difficolta a risolvere l’impasse e il suo ruolo sarà solo quello di rappresentare “una spugna morale” che dovrà assorbire il risentimento della comunità, insieme a tutta la nostra ipocrita irresponsabilità sociale.
Riferimenti
Andler, D., 2023, Intelligence artificielle, intelligence humaine: la double énigme, Paris, Gallimard; trad. it. Il duplice enigma. Intelligenza artificiale e intelligenza umana, Torino, Einaudi 2024.
Arendt, H., 1954, Le origini del totalitarismo, Torino, Einaudi 2009.
Beniger, J. R., 1995, Le origini della società dell’informazione. La rivoluzione del controllo, Torino, Utet.
boyd, d., “The messy reality of Algorithmic Culture”, youtube.
Elish, M. C., 2019, “Moral Crumple Zones: Cautionary Tales in Human Robot Interaction“, in Engaging Science, Technology, and Society, v. 5, pp. 40-60.
Kneusel, R. T., 2023, How AI Works: From Sorcery to Science, S. Francisco, No Starch Press.
Mitchell, M., 2022, L’intelligenza artificiale. Una guida per esseri umani pensanti, Torino, Einaudi.
Mumford, L., 1954, In the Name of Sanity, New York, Harcourt, Brace, and Company; trad. it. In nome della ragione, Torino, Edizione comunità, 1959.
New York Times, 1958, NEW NAVY DEVICE LEARNS BY DOING; Psychologist Shows Embryo of Computer Designed to Read and Grow Wiser, 8 luglio.
Polson, N., Scott, J., 2019, Numeri Intelligenti. La matematica che fa funzionare l’intelligenza artificiale di Google, Facebook, Apple & Co., Torino, Utet.
Pozza, G., 2025, “Perché l’AI consuma sempre più energia (nonostante Deepseek)“, Agenda Digitale.eu.
Striphas, T, 2023, Algorithmic Culture before the Internet, New York, Columbia University Press; trad. it. La cultura algoritmica prima di Internet, Milano-Udine, Mimesis 2024.
Turing, A., 1950, “Computing Machinery and Intelligence“, in Mind, New Series, Vol. 59, No. 236 (Oct.), pp. 433-460, Oxford University Press on behalf of the Mind Association.
Wikipedia, Macchina di Turing.
